Architektur
Es wurden getrennte Bausteine für Sensordatenerfassung, Referenzkartenaufbereitung, Lokalisierung, Routing, AR-Darstellung, Auftragsdaten und Offline-Auswertung konzipiert und implementiert. Wissenschaftlich-technisch zentral ist die methodische Ausrichtung auf einen robusten, segment- und korrelationsbasierten Ansatz (Abbildung 1).
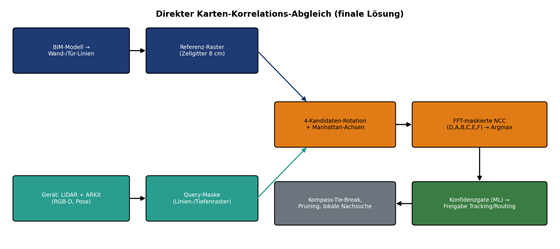
Abbildung 1: Finale Methode als Pipeline. Der BIM-Referenzstrang (oben) und der Gerätestrang aus LiDAR/ARKit (unten) werden im Korrelationsabgleich zusammengeführt; Nachbearbeitung und ML-Konfidenzgate folgen.
Segmentierung und Konfidenzmodellen
Maschinelles Lernen erfüllt im Endsystem zwei klar abgegrenzte Rollen:
(1) die On-Device- Segmentierung der Gebäudemerkmale als Eingangsstufe und
(2) Konfidenzmodelle für die Qualitäts- und Freigabebewertung.
On-Device-Segmentierung der Gebäudemerkmale (EfficientViT-Seg)
Die geometrische Query-Maske wird mit Klasseninformation (Wand, Tür, …) angereichert; diese semantische Information stammt im aktuell ausgelieferten App-Stand aus der nativen ARKit-Klassifizierung des Geräts (Abbildung 2 zeigt die daraus abgeleiteten Segment-Klassen einer realen Beobachtung).
Parallel wurde im Projekt ein dediziertes, anwendungsspezifisches Segmentierungsmodell entwickelt, das die native ARKit-Klassifizierung künftig ersetzen soll. Hierfür wurde der ADE20K-Datensatz auf sechs für die Navigation relevante Gebäudeklassen (Wand, Boden/Flur, Decke, Tür, Fenster, Treppe) umkartiert und eine eigene Trainings- und On-Device-Auswertungsumgebung aufgebaut. Verglichen wurden einstufige CNNs (YOLOv11, Varianten n–x) mit transformerbasierten Modellen (EfficientViT-Seg, Varianten b1–l2). Die Ergebnisse sind in der Publikation „On-Device Semantic Segmentation of Building Features for Indoor Navigation” [2] dokumentiert.
Als finales Modell wurde EfficientViT-Seg gewählt. Auf dem iPad Pro M4 erreicht es an der Genauigkeitsgrenze 68,8 mIoU bei 13,8 ms/Frame (Variante l1) und ist damit zugleich genauer und schneller als das stärkste YOLOv11-Modell (67,7 mIoU bei 17,0 ms); ausschlaggebend sind außerdem die vollständige CoreML-Integration (die Nachbearbeitung ist in das kompilierte Modell eingebettet) und die permissive Apache-2.0-Lizenz (vs. AGPL-3.0 bei YOLOv11). Da das Modell spezifisch auf den Anwendungsfall trainiert ist, wird durch die Ablösung der generischen ARKit-Klassifizierung eine weitere Verbesserung der Lokalisierungsergebnisse erwartet (Abbildungen 3 und 4).
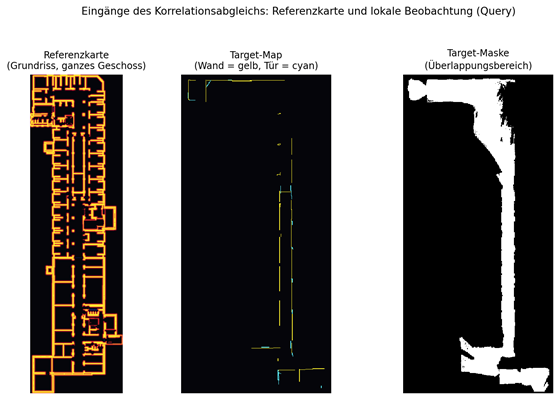
Abbildung 2: Eingänge des Korrelationsabgleichs – Referenzkarte, Target-Map und Target-Maske. Links die Referenzkarte (rasterisierter Grundriss des gesamten Geschosses); Mitte die Target-Map der lokalen Beobachtung (Query) mit Wand- (gelb) und Tür-Segmenten (cyan, aktuell aus nativer ARKit-Klassifizierung); rechts die Target-Maske, die den beobachteten Überlappungsbereich markiert und in der maskierten NCC ausschließlich gültige Zellen einbezieht. Die Panels sind nicht maßstabsgleich (Referenz = ganzes Geschoss, Target = lokaler Ausschnitt).
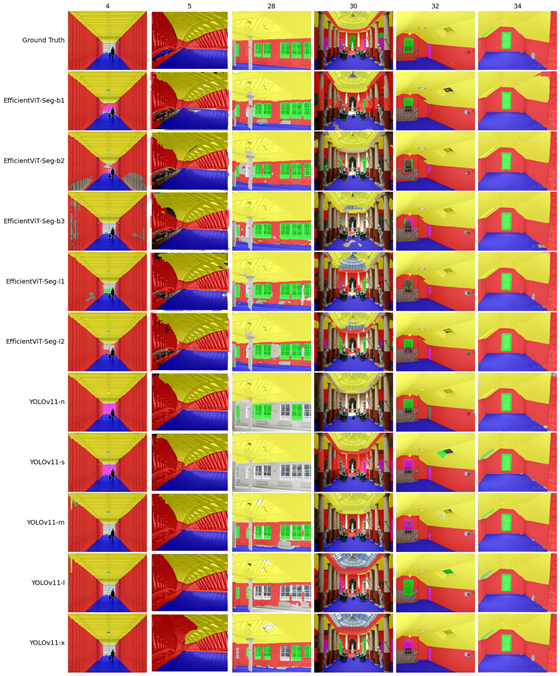
Abbildung 3: Qualitative Segmentierungsergebnisse – Grundwahrheit (oben) vs. Vorhersagen von EfficientViT-Seg (b1–l2) und YOLOv11 (n–x) über sechs Szenen. Quelle: [2].
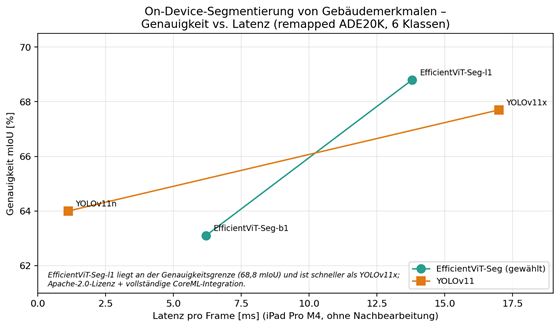
Abbildung 4: Genauigkeit vs. Latenz der Segmentierungsmodelle: Genauigkeit (mIoU) vs. Latenz auf dem iPad Pro M4. EfficientViT-Seg-l1 liegt an der Genauigkeitsgrenze und ist schneller als YOLOv11x. Quelle: [2].
Konfidenzmodelle für Qualitäts- und Freigabebewertung
Der zweite ML-Strang bewertet die Belastbarkeit der Lokalisierung und steuert die Freigaben. Die Modelle entscheiden,
- ob eine Rotationswahl belastbar ist (Rotationssicherung),
- ob eine Lokalisierung als sicher gilt,
- ob darauf die Routenführung freigegeben werden darf (Routenfreigabe), und
- ob unterlegene Rotationskandidaten früh und sicher ausgeschlossen werden können (Kandidatenausschluss).
Die Konfidenzmodelle werden auf annotierten Evaluationsläufen angepasst (leichtgewichtige Entscheidungsbäume, ohne externe ML-Abhängigkeit). In der Auswertung erreichen die besten Modelle Präzision 1,0 bei einem Recall von etwa 0,96–1,0 (Abbildung 5). Wichtig ist, dass die Präzision fest auf 1,0 gehalten wird: Eine Freigabe wird nur ausgesprochen, wenn sie tatsächlich korrekt ist; der Entscheidungsbaum hebt dabei den Recall deutlich über einen einzelnen Schwellwert (z. B. bei Lokalisierung/Routing von ~0,51 auf ~0,97).
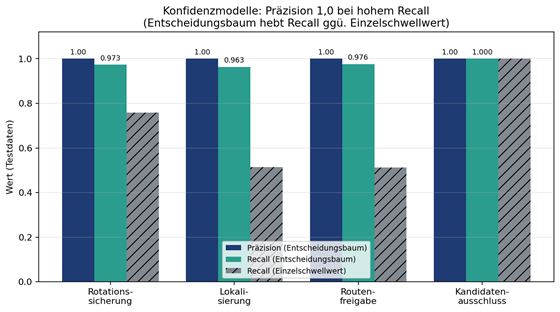
Abbildung 5: Präzision/Recall der Konfidenzmodelle (Entscheidungsbaum, Testdaten): Präzision durchgängig 1,0; Recall 0,96–1,0. Der Baum hebt den Recall gegenüber einem Einzelschwellwert deutlich an. Quelle: Heuristik-Auswertung, Konfiguration mit lokaler Nachsuche.
Initialisierung und Relokalisierung
Dieses Arbeitspaket bildet den Kern der finalen Lösung. Statt einer globalen Subkartensuche mit MixVPR/TEASER++ arbeitet das Endsystem mit einem direkten Kartenabgleich:
- Referenzaufbereitung: Aus der Referenzkarte (aus dem BIM-Modell abgeleitete Wand- und Türlinien) werden Wand-/Tür-Segmente in ein Zellgitter (8 cm) rasterisiert (Abbildung 2, linkes Panel). Für die Referenzkomponenten wird ein Nächste-Segment-Distanzfeld verwendet, um den Abgleich gegenüber Mess- und Diskretisierungsrauschen zu glätten.
- Beobachtungsaufbereitung: Die auf dem Gerät beobachtete Umgebung wird aus LiDAR-/ARKit-Daten als Linien- und Tiefenmaske (Query) erzeugt.
- Abgleich: Referenz und Query werden mittels FFT-basierter, maskierter normalisierter Kreuzkorrelation (NCC) über alle gültigen 2D-Verschiebungen verglichen. Pro Verschiebung werden die gewichteten Momentsummen D, A, B, C, E, F im Fourier-Raum ausgewertet; nur Verschiebungen mit ausreichender Überlappung gehen ein. Wände und Türen werden in getrennten Kanälen korreliert und gewichtet kombiniert.
- Rotationssuche: Da die Orientierung unbekannt ist, wird eine Vier-Kandidaten- Rotationssuche entlang der dominanten (Manhattan-)Wandachsen durchgeführt (Abbildung 6). Eine Manhattan-Achsen-Stabilisierung über die Sitzung hinweg hält die Kandidatenreihenfolge stabil und verhindert Identitätswechsel der Kandidaten von Bild zu Bild.
- Auswahl und Nachbearbeitung: Das Argmax über die Korrelationsflächen liefert Position und Rotation (Abbildung 7). Ein Kompass-Stichentscheid löst 180°-Mehrdeutig- keiten; ein frühzeitiger Kandidatenausschluss schließt unterlegene Rotationen aus; eine lokal begrenzte Nachsuche verfeinert die Pose nach erfolgreicher Erstlokalisierung.
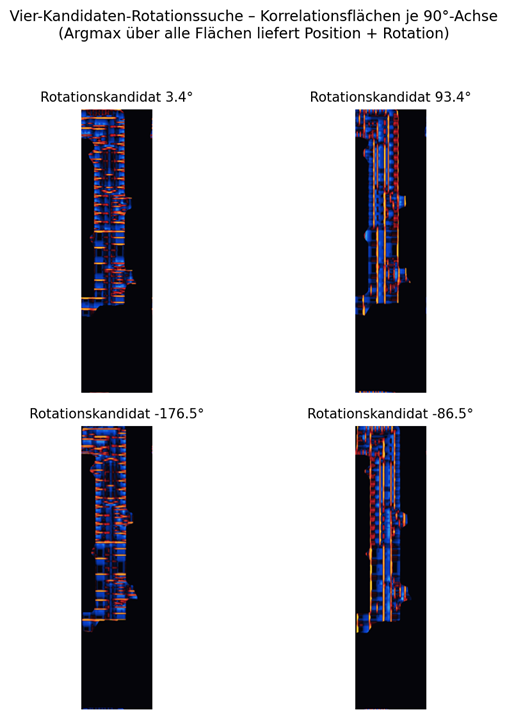
Abbildung 6: Vier-Kandidaten-Rotationssuche: Korrelationsflächen der vier 90°-versetzten Rotationskandidaten für eine Beobachtung. Das Argmax über alle Flächen bestimmt Position und Rotation.
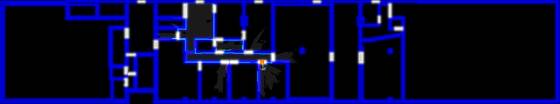
Abbildung 7: Lokalisierungs-Overlay: Qualitatives Lokalisierungsergebnis in den BitCtrl-Räumlichkeiten (zweiter Standort): Die lokale Geräte-Beobachtung wird korrekt auf den Grundriss (blau) registriert; die geschätzte Kameraposition ist markiert (orange).
Demonstrator
Zum Projektende liegt ein durchgängiger Demonstrator vor: Auftragsdaten können geladen werden, Referenzkarten und Gebäudegraphen werden eingebunden, die Route wird berechnet, Abweichungen von der Route werden erkannt und in der AR-Ansicht mit visueller sowie sprachlicher Führung unterstützt. Damit ist aus einem Lokalisierungsansatz ein tatsächlich nutzbares mobiles Assistenzsystem für Servicetechniker geworden.
Das Video zeigt die laufende App auf dem HTW-Campus: die AR-Navigationsansicht mit eingeblendeter Route sowie die Führung über mehrere Gebäudeabschnitte eines Rundgangs.